设计创意
AI 图片模型怎么选?用统一 Brief 做 5 步品牌视觉压力测试
Images 2.6、Recraft V4.1 Pro 和其他图像模型同时更新后,最容易陷入的误区是拿几张热门样片就决定工具。真正可靠的选择,应来自同一品牌 Brief 下的压力测试。
边界说明:本文依据 OpenAI、Recraft 与 Figma 的公开资料整理测试方法,示例提示词与评分表由本站编写。本文不把厂商样片当成本站实测,也不承诺任何模型在你的品牌、地区、语言或授权场景中必然表现相同。
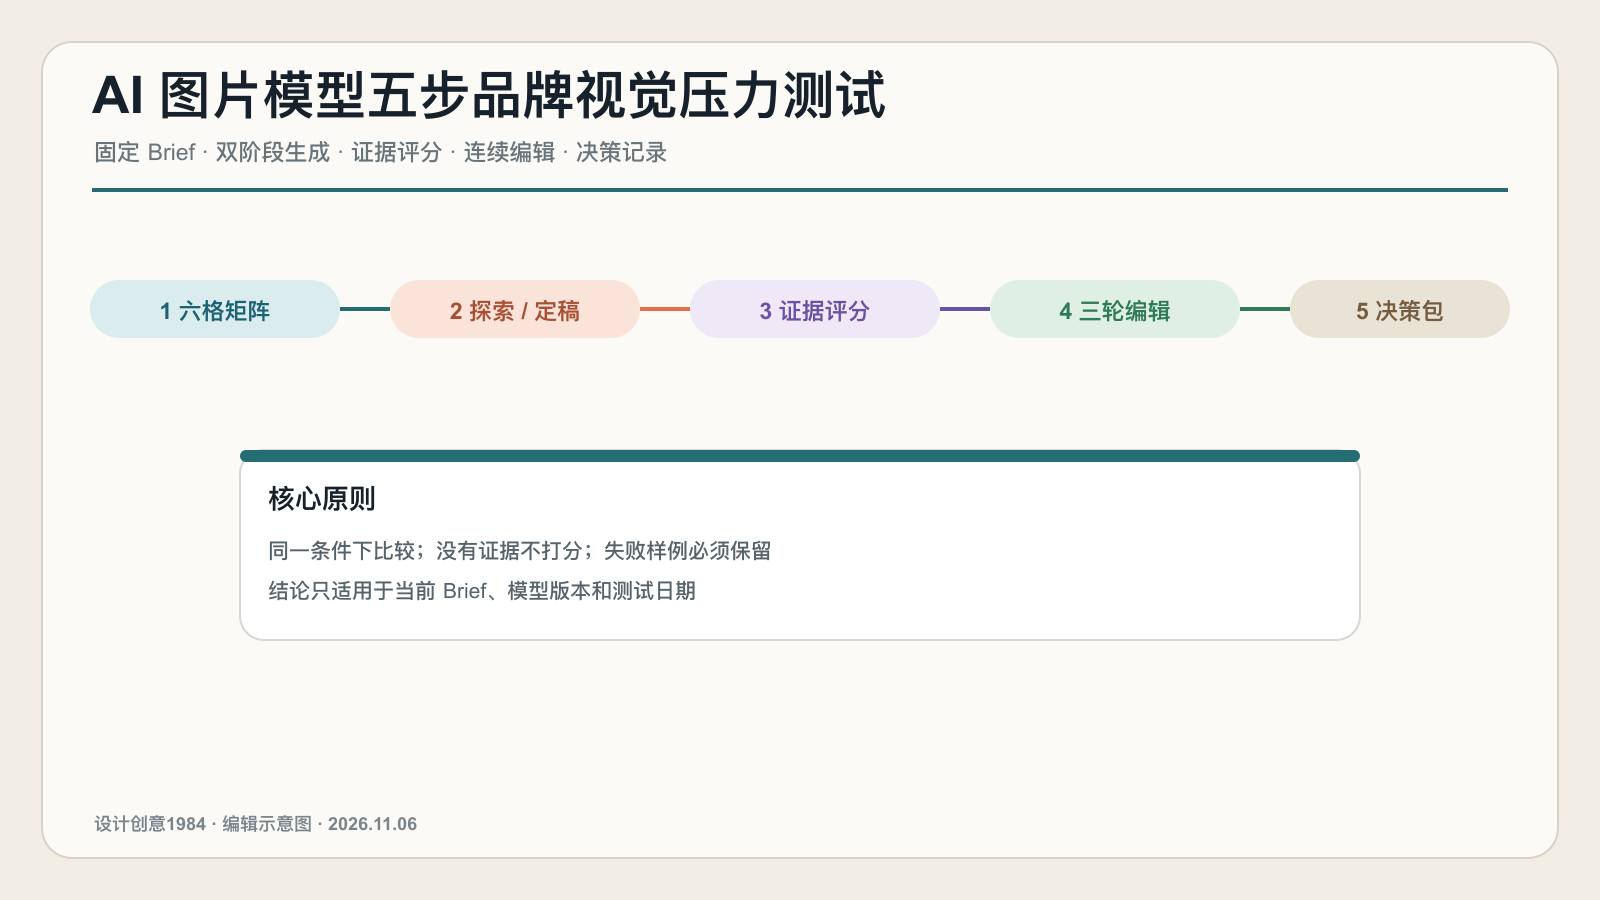
准备:先写“不可变化项”,再写想探索的风格
把品牌色、Logo 安全区、产品结构、人物身份、必需文字、禁用元素、渠道尺寸和授权要求分成硬约束;把构图、镜头、材质和氛围放进可探索项。若两类内容混在一起,模型失误和创意变化就无法区分。
提示词:
你是品牌视觉测试负责人。先不要生成图片。
请把以下 Brief 拆成:
1. 不可变化的品牌与产品事实;
2. 可以探索的视觉变量;
3. 必须拒绝的内容;
4. 交付尺寸、格式和文字要求;
5. 需要人工或法务确认的未知项。
任何 Brief 中没有写明的事实标记为“待确认”,不要自行补齐。

【粘贴 Brief】
第一步:建立 6 格测试矩阵,不用一条提示词决定胜负
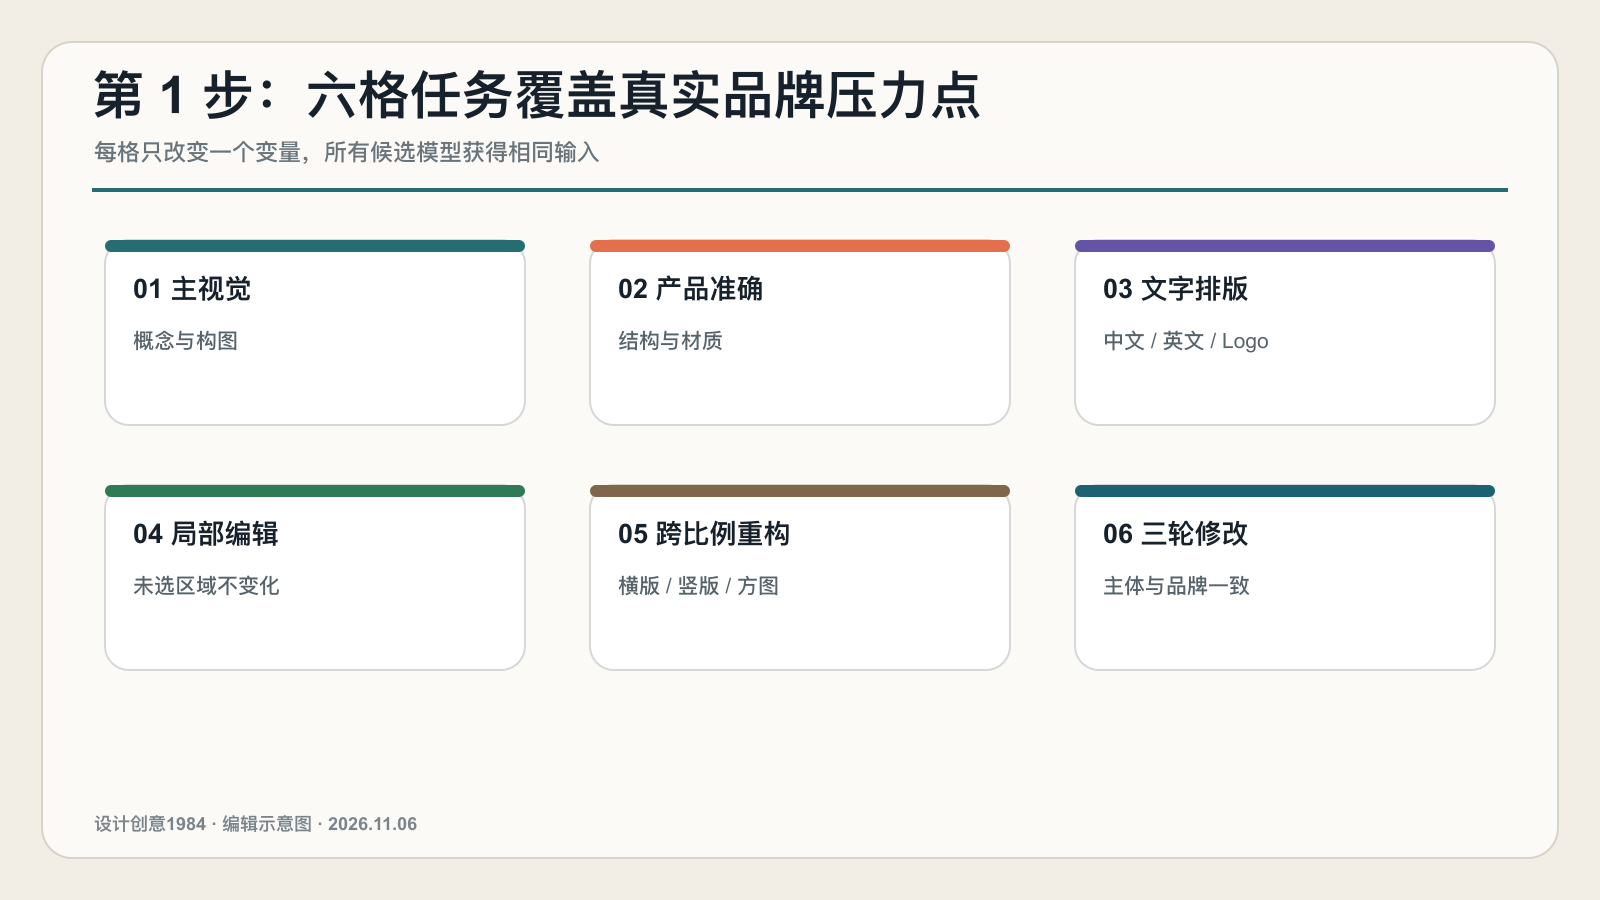
建议至少测试:主视觉、产品结构、中文与英文文字、同一主体的多轮编辑、不同尺寸重构、失败恢复。每一格固定参考图、尺寸、轮次和输出数量,避免某个模型因为多抽了几次而占便宜。
提示词:
基于已确认的品牌约束,为同一项目建立 6 组测试任务:
主视觉、产品准确性、文字排版、局部编辑、跨比例重构、连续三轮修改。
每组只改变一个变量,并写明:输入、固定参数、期望输出、失败条件、人工检查点。
不要把模型名称写进任务,确保所有模型收到完全相同的测试。
第二步:分开跑“探索轮”和“定稿轮”
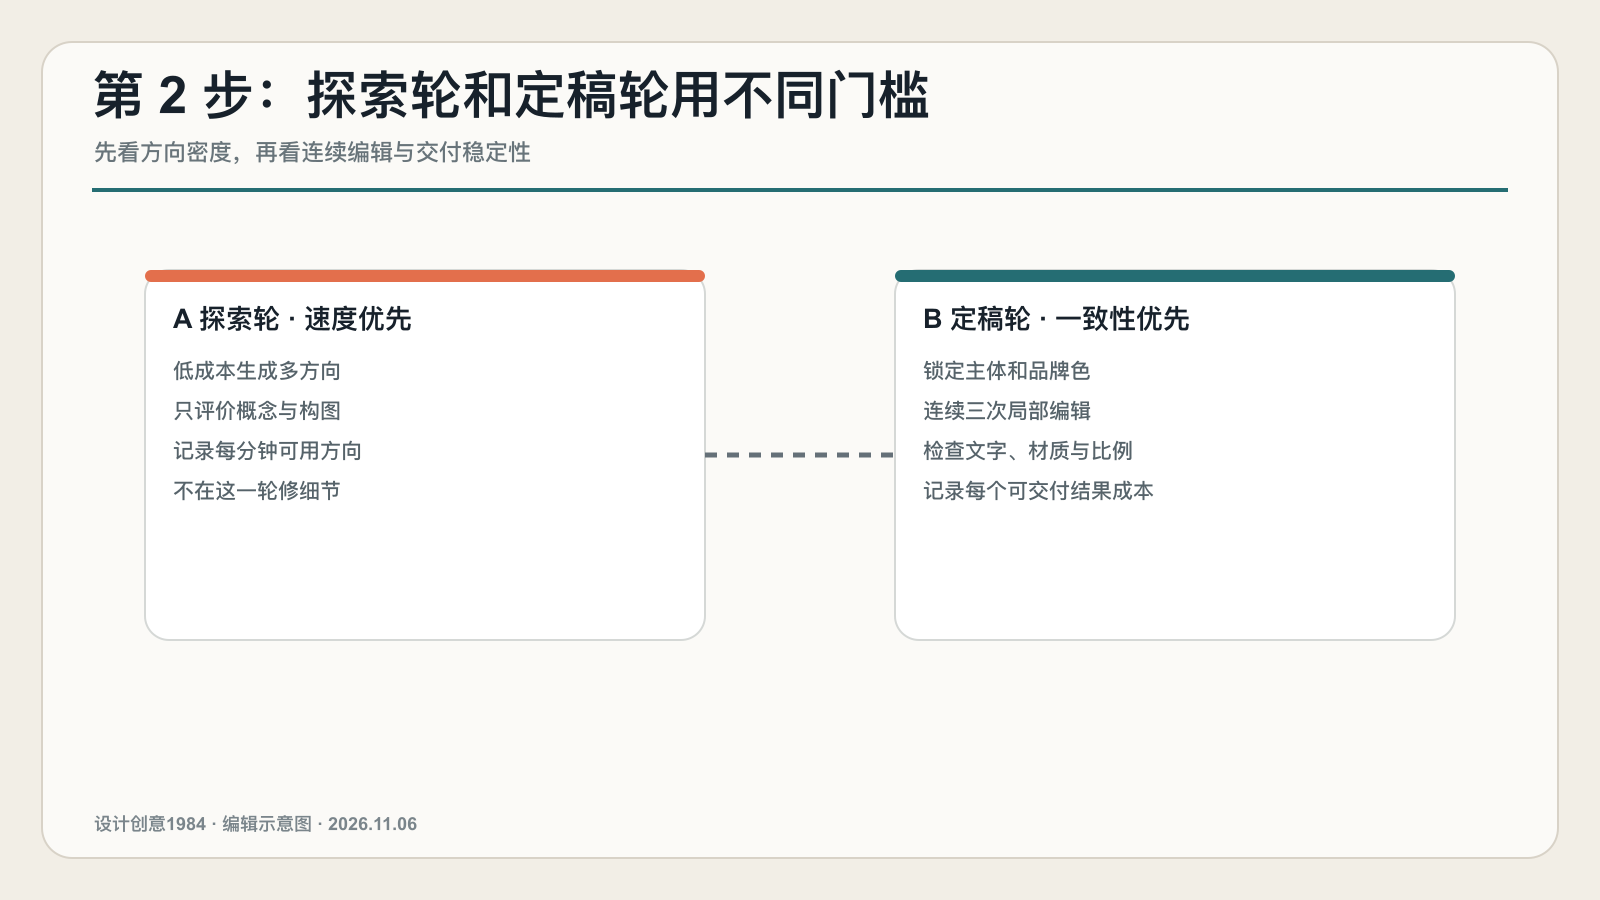
探索轮看每分钟产生多少个可用方向;定稿轮看主体、文字、材质和构图在多次编辑后是否保持。Images 2.6 的 Flare 与 Sunburst 正好提醒我们:快并不自动等于更适合最终交付。
提示词:
请为同一 Brief 输出两个阶段的执行表:
A. 探索轮:低成本、快速、多方向,只评估构图与概念价值;
B. 定稿轮:固定主体与品牌元素,连续修改三次,评估一致性和可控性。
记录每张图的模型、版本、参数、耗时、成本、提示词、参考图和淘汰原因。
第三步:用可观察证据评分,不用“更有感觉”
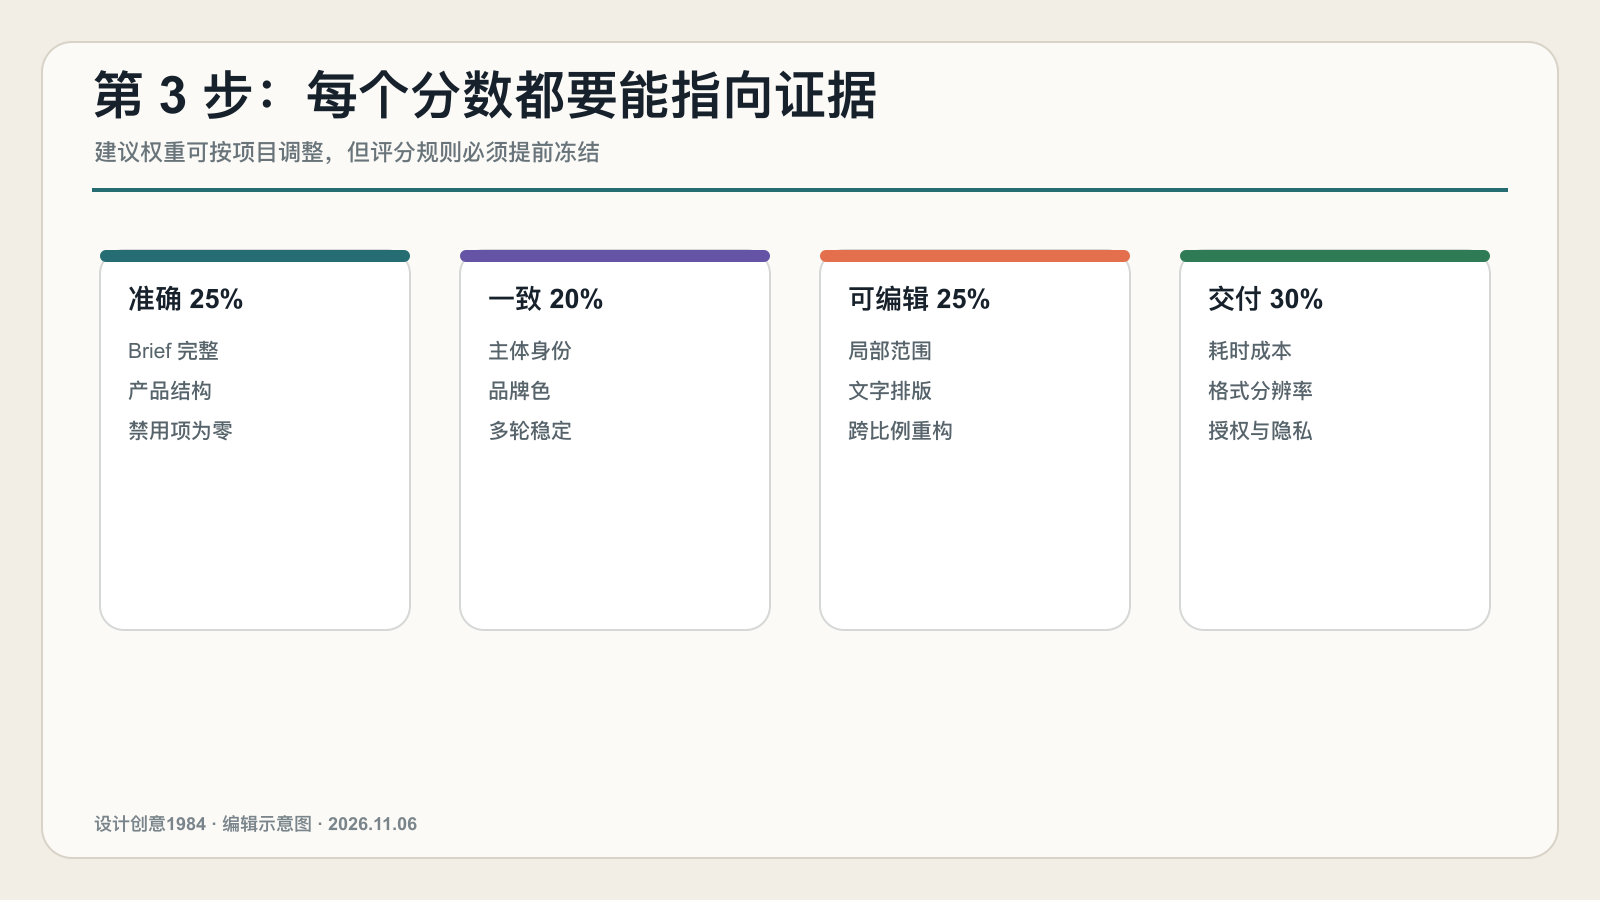
评分维度可设为:Brief 准确 25%、主体一致 20%、文字与排版 15%、局部编辑 15%、速度成本 10%、版权与风险 15%。每个分数必须附截图、差异图或失败样例。
提示词:
把测试结果整理成评分卡。每项 0–5 分,但没有证据不得打分。
对每个模型列出:通过样例、失败样例、与基线图的变化、文字错误、主体漂移、不可控新增元素、耗时、成本、授权或隐私风险。
最后按项目权重计算总分,并单独列出“一票否决项”。
第四步:专门做三轮局部编辑,检查“越改越不像”
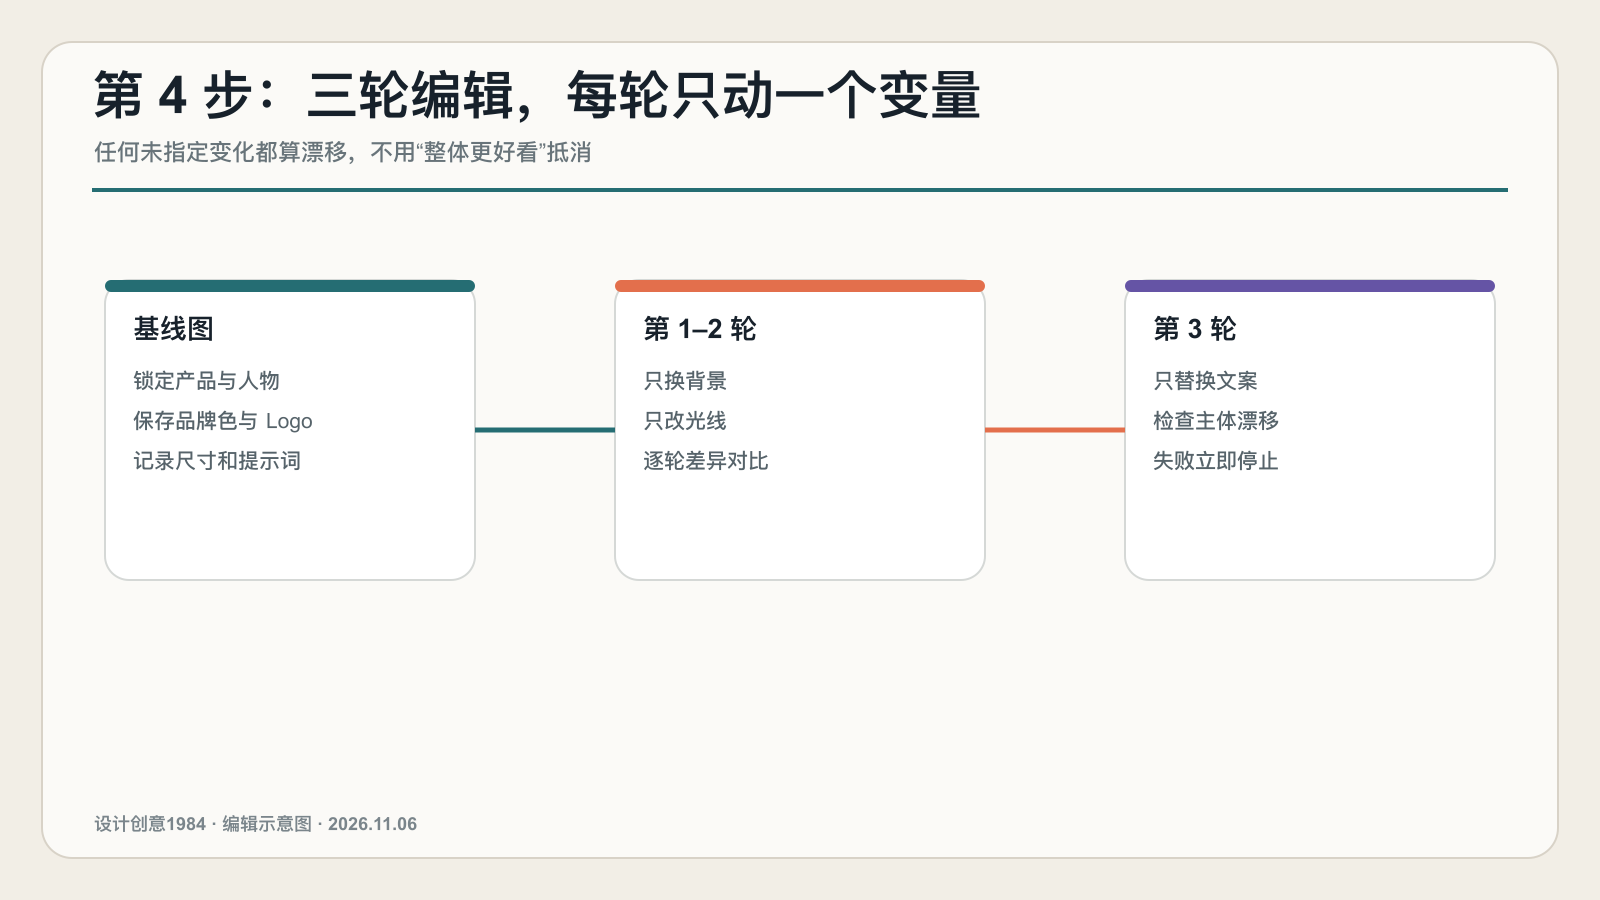
连续编辑是品牌生产中最常见也最容易翻车的环节。第一轮只换背景,第二轮调整光线,第三轮改文案;每轮都与最初基线比较产品比例、Logo、人物、色值与未指定区域。
提示词:
对基线图依次执行三轮编辑,每轮只改一个变量:
1. 仅更换背景;
2. 仅调整光线方向和强度;
3. 仅替换指定文案。
禁止改变产品结构、人物身份、Logo、品牌色和未选区域。
每轮结束后列出实际变化与意外变化;若出现漂移,停止并保留失败证据。
第五步:形成可追溯的模型决策记录
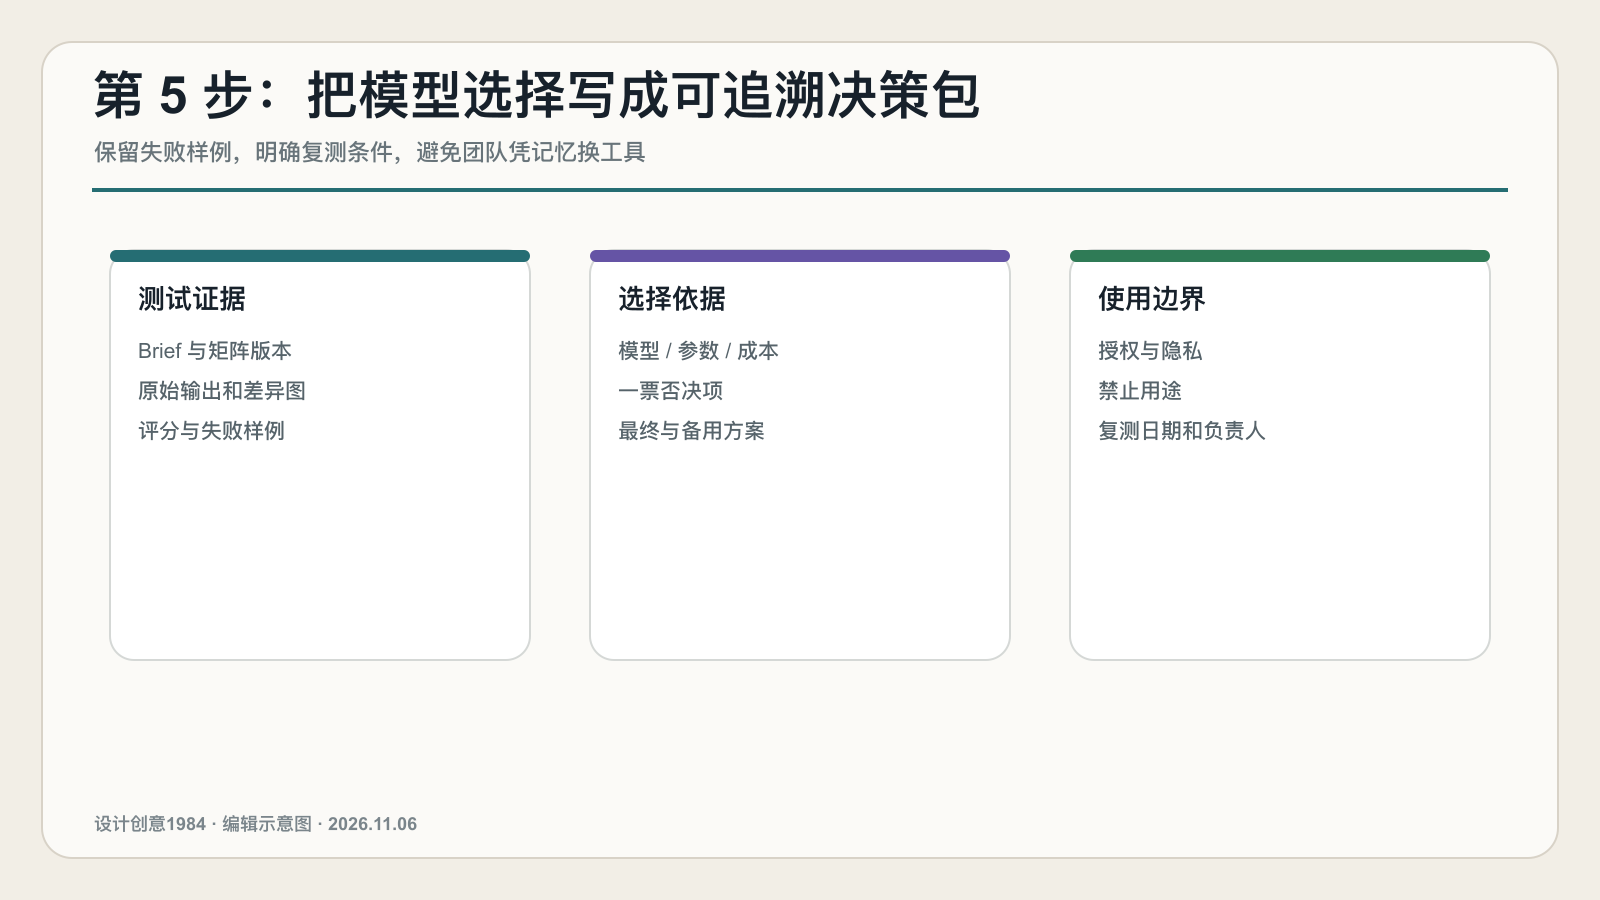
不要只在群聊里说“以后用这个模型”。交付包至少应包含 Brief 版本、测试矩阵、原始输出、评分证据、模型与参数、成本、授权说明、禁止用途、复测日期和负责人。
提示词:
生成一份模型选择记录,不删除失败样例。
包含:项目目标、Brief 版本、候选模型与版本、测试条件、评分与证据、一票否决项、最终选择、备用方案、成本上限、授权/隐私限制、何时必须重新测试、负责人签字。
明确写出:此次结论只适用于当前 Brief 和测试日期。
本站判断:模型排行榜不如团队自己的基准集
厂商更新速度越来越快,今天的第一名很快会变化。真正能复用的是你自己的品牌基准集、失败样例和评分规则。它们让每次换模型都能在相同条件下复测,而不是从审美争论重新开始。
成本、版权与限制
- 记录每次生成和编辑的真实费用,避免只比较单张标价。
- 确认输入图片、字体、Logo、人物肖像和模型输出的授权范围。
- 保密产品图不要上传到未经批准的服务;企业项目先核对数据保留政策。
- 人工检查中文文字、商标、产品结构、人物身份和敏感内容,不把自动评分当最终批准。
本文由「设计创意1984」整理编辑,转载请注明出处。
关注设计创意1984,持续获取设计趋势、AI创作方法与创意灵感。
via:OpenAI:Introducing Images 2.6、Recraft:GPT Image 2.6 comparison、Figma:Workflow Lab
本文由 设计创意1984 作者:admin 发表,转载请注明来源!

admin
文章:105